Une API Django qui fonctionne pour 100 utilisateurs ne fonctionnera pas forcément pour 10 000. Ces patterns, je les ai implémentés en réaction à des incidents en production. Autant les mettre en place dès le début.
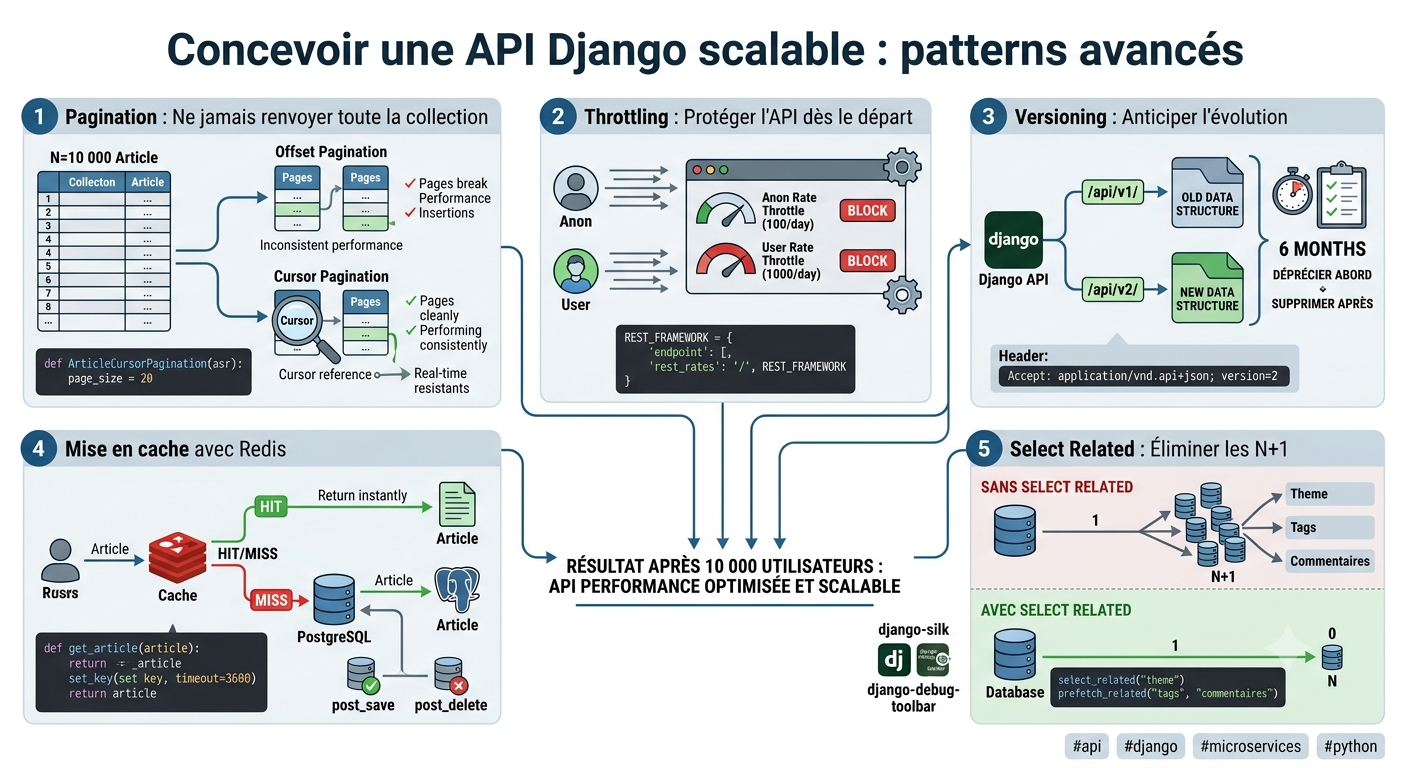
Pagination : ne jamais renvoyer toute la collection
La pagination par offset (?page=5) est simple mais dangereuse sur les grands datasets : une requête OFFSET 50000 scanne les 50 000 premières lignes avant de renvoyer les 20 suivantes. La pagination par curseur est supérieure :
class ArticleCursorPagination(CursorPagination):
    page_size = 20
    ordering = "-created_at"
Performance constante quelle que soit la page, résistante aux insertions en temps réel.
Index BDD : le levier le plus sous-estimé
class Article(models.Model):
    class Meta:
        indexes = [
            # Requêtes filtrées par statut + triées par date
            models.Index(fields=["statut", "-date_publication"]),
            models.Index(fields=["titre"], name="idx_article_titre"),
        ]
Utilisez EXPLAIN ANALYZE en PostgreSQL ou EXPLAIN en MySQL pour détecter les seq scans. Un index bien placé peut transformer une requête de 2s en 5ms.
Select related : éliminer les N+1 en amont
# ? N+1 : 1 requête pour la liste + 1 par article pour le thème
articles = Article.objects.filter(statut="publie")

# ? 2 requêtes pour tout
articles = (
    Article.objects
    .filter(statut="publie")
    .select_related("theme")
    .prefetch_related("tags", "commentaires")
)
Installez django-debug-toolbar pour détecter les N+1 automatiquement en développement.
Throttling : protéger l'API dès le départ
REST_FRAMEWORK = {
    "DEFAULT_THROTTLE_CLASSES": [
        "rest_framework.throttling.AnonRateThrottle",
        "rest_framework.throttling.UserRateThrottle",
    ],
    "DEFAULT_THROTTLE_RATES": {
        "anon": "100/day",
        "user": "1000/day",
    },
}
Cache Redis : mesurer avant d'optimiser
from django.core.cache import cache

def get_articles_vedette():
    key = "articles:vedette:v1"
    articles = cache.get(key)
    if articles is None:
        articles = list(
            Article.objects.filter(est_en_vedette=True, statut="publie")
            .select_related("theme").prefetch_related("tags")[:6]
        )
        cache.set(key, articles, timeout=1800)
    return articles
Monitoring : ce qu'il faut mesurer en production
- Latence P50, P95, P99 par endpoint (pas juste la moyenne)
- Taux d'erreur 4xx / 5xx — un pic de 4xx peut indiquer une attaque
- Hits/misses de cache — un taux de miss > 80% signale un problème
- Slow queries — PostgreSQL a
log_min_duration_statement
?
Stack recommandée : Sentry (erreurs) + Prometheus/Grafana (métriques).