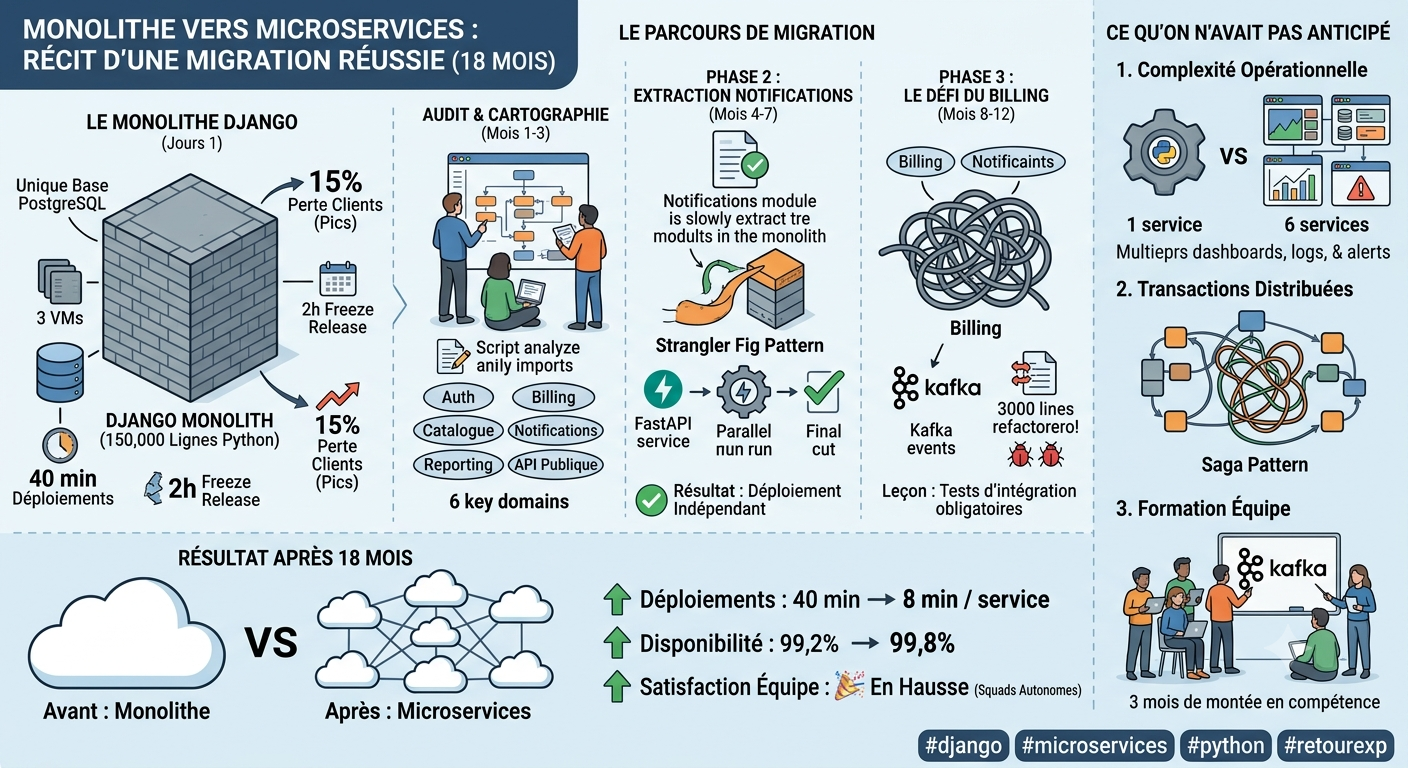
Notre plateforme SaaS avait 5 ans et 150 000 lignes de Python. Les déploiements prenaient 40 minutes et chaque release impliquait un gel de 2 heures. Le CTO a validé la migration après qu'on a perdu 15% de clients à cause des temps de réponse en période de pic. Voici ce qui s'est réellement passé.
Phase 1 : Audit et cartographie (mois 1-3)
On a commencé par le plus ennuyeux : cartographier les dépendances. Un script d'analyse statique des imports Python nous a révélé 6 domaines métier : auth, billing, catalogue, notifications, reporting, API publique.
Notifications et reporting avaient le moins de dépendances entrantes. Règle fondamentale : extrayez toujours les domaines périphériques en premier. Les erreurs coûtent moins cher à cet endroit.
Phase 2 : Extraction des Notifications (mois 4-7)
Nouveau service FastAPI dédié. Migration en 3 étapes strictes :
- Dupliquer la logique dans le nouveau service (les deux tournent)
- Faire passer le trafic progressivement (10% ? 50% ? 100%) via feature flag
- Supprimer le code monolithe seulement quand l'ancien service n'est plus appelé depuis 30 jours
Résultat : déploiement indépendant, équipe de 2 personnes autonome. Le service de notifications n'a plus aucune dépendance du monolithe.
Phase 3 : Le billing — là où tout s'est compliqué
La facturation était enchevêtrée dans 23 endroits différents du codebase. On a dû introduire des events Kafka et refactoriser 3 000 lignes. Deux bugs critiques en production. L'un d'eux a causé des doubles facturations pour 47 clients.
La leçon la plus dure : les tests d'intégration inter-services ne sont pas optionnels. On les avait négligés pour "aller vite". On a payé le prix.
Ce qu'on n'avait pas anticipé
- La complexité opérationnelle explose. 1 service ? 6 services = 6 fois plus de dashboards, alertes, runbooks, logs à corréler.
- Les transactions distribuées sont un problème non résolu. Le saga pattern est difficile à implémenter correctement et encore plus difficile à déboguer.
- La formation de l'équipe prend du temps. 3 mois pour que tout le monde soit à l'aise avec Kafka et les traces distribuées.
Résultat après 18 mois
- Déploiements : 40 min ? 8 min par service
- Disponibilité : 99,2% ? 99,8%
- Satisfaction équipe : nettement en hausse, chaque squad est propriétaire de son périmètre
Est-ce que je recommencerais ?
Oui — mais en commençant encore plus petit. Extraire un seul service, le stabiliser complètement, apprendre de ce premier chantier avant de passer au suivant. La tentation de tout migrer d'un coup est forte. Elle est presque toujours une erreur.